Pendant longtemps, NVIDIA était surtout connue du grand public pour ses cartes graphiques.
Aujourd’hui, ses technologies se trouvent au cœur des infrastructures utilisées pour entraîner et faire fonctionner certains des systèmes d’intelligence artificielle les plus exigeants au monde.
Ce basculement pourrait donner l’impression que NVIDIA a simplement conçu la bonne puce au bon moment.
La réalité est plus profonde.
NVIDIA n’a pas seulement construit des GPU plus puissants. Elle a progressivement construit les différentes couches nécessaires pour transformer ces GPU en infrastructure : programmation, bibliothèques logicielles, interconnexions, réseaux, systèmes complets et outils de déploiement.
C’est cette intégration qui permet de comprendre comment une entreprise historiquement associée au graphisme est devenue l’un des principaux fournisseurs de l’infrastructure mondiale de l’IA.
1. Le pari qui précède l’explosion de l’IA
L’histoire commence bien avant ChatGPT et les grands modèles de langage.
Un GPU a été conçu à l’origine pour effectuer simultanément un très grand nombre d’opérations nécessaires au rendu graphique. Cette capacité à paralléliser les calculs s’est progressivement révélée utile bien au-delà du jeu vidéo.
Le problème était alors simple : disposer de processeurs massivement parallèles ne suffisait pas. Encore fallait-il permettre aux développeurs de les programmer sans devoir détourner des outils conçus pour le graphisme.
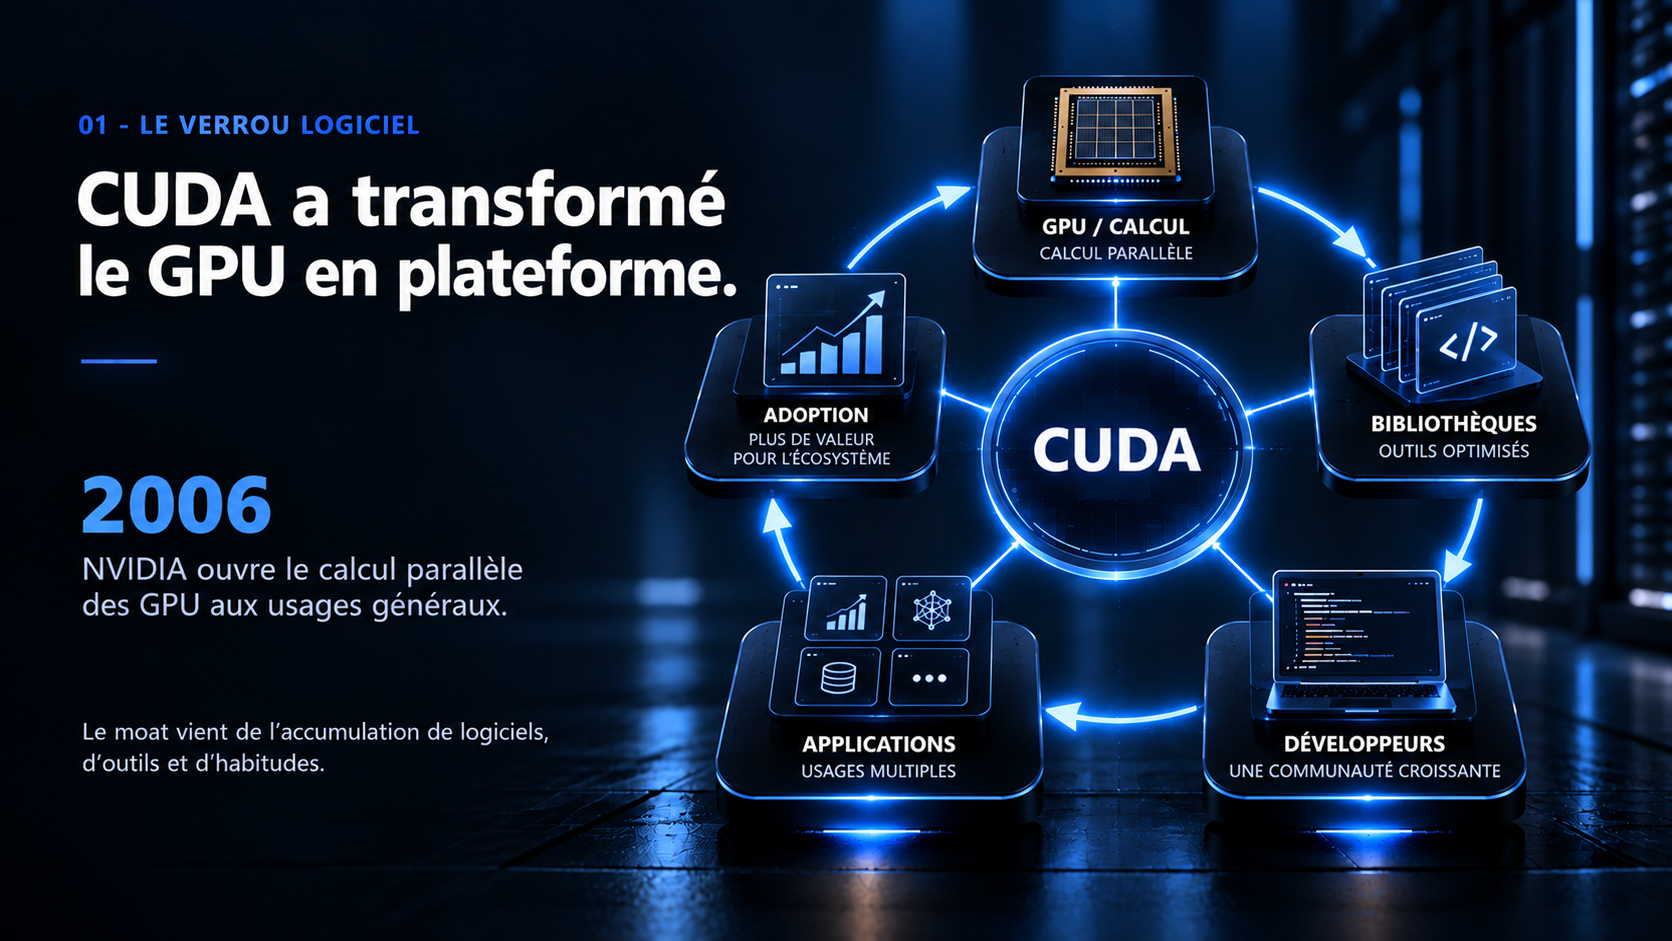
En 2006, NVIDIA introduit CUDA, une plateforme de calcul parallèle et un modèle de programmation permettant d’utiliser les capacités des GPU pour des tâches générales.
Cette décision est fondamentale.
NVIDIA ne vend désormais plus seulement une puce.
Elle fournit également la couche permettant aux chercheurs et aux développeurs de construire du logiciel autour de cette puce.
Au fil des années viennent s’ajouter compilateurs, bibliothèques optimisées, outils de développement et frameworks spécialisés. NVIDIA indique aujourd’hui que son écosystème CUDA compte plus de six millions de développeurs et quelque 40 000 entreprises utilisant ses plateformes. Ces chiffres proviennent de NVIDIA et doivent donc être compris comme des métriques déclarées par l’entreprise.
C’est ici que commence le véritable avantage de NVIDIA : chaque nouvelle génération de matériel arrive dans un environnement logiciel qui existe déjà.
Un concurrent peut concevoir un accélérateur très performant.
Reproduire simultanément le matériel, les bibliothèques, les outils, les optimisations et les habitudes accumulées par les développeurs est une autre affaire.
Le coût de substitution ne se mesure donc pas uniquement au prix d’une puce. Il inclut aussi le temps nécessaire pour adapter, tester, optimiser et maintenir les logiciels qui l’utilisent.
2. Puis l’intelligence artificielle change d’échelle
Cette avance logicielle aurait pu rester cantonnée au calcul scientifique et à quelques applications spécialisées.
L’apprentissage profond change la trajectoire.
Les réseaux neuronaux modernes reposent largement sur des opérations mathématiques parallélisables. Les GPU deviennent donc particulièrement adaptés à l’entraînement de ces modèles.
Mais à mesure que les modèles grossissent, un nouveau problème apparaît.
Un seul GPU ne suffit plus.
Il faut faire travailler ensemble des dizaines, puis des centaines et des milliers d’accélérateurs.
À cette échelle, la performance d’un système ne dépend plus seulement de la vitesse de chaque processeur. Elle dépend aussi de la vitesse à laquelle les processeurs peuvent échanger leurs données.
Le réseau devient une partie du calcul.
3. Le coup stratégique de Mellanox
C’est ce qui donne une autre dimension à l’acquisition de Mellanox.
NVIDIA annonce en 2019 son intention d’acquérir le spécialiste des interconnexions haute performance pour une valeur d’entreprise d’environ 6,9 milliards de dollars. L’opération est finalisée en avril 2020.
À première vue, acheter une entreprise de réseau peut sembler éloigné du métier historique des GPU.
Avec l’IA à grande échelle, c’est exactement l’inverse.
Lorsqu’un modèle est réparti sur un grand nombre d’accélérateurs, les GPU doivent constamment communiquer. Un processeur extrêmement rapide peut rester sous-utilisé si les données n’arrivent pas suffisamment vite.
Mellanox apporte notamment à NVIDIA une expertise stratégique dans les interconnexions et InfiniBand.
NVIDIA développe parallèlement NVLink, puis étend sa présence dans Ethernet avec Spectrum-X.
La société ne cherche donc plus seulement à accélérer chaque GPU.
Elle cherche à accélérer l’ensemble du système.
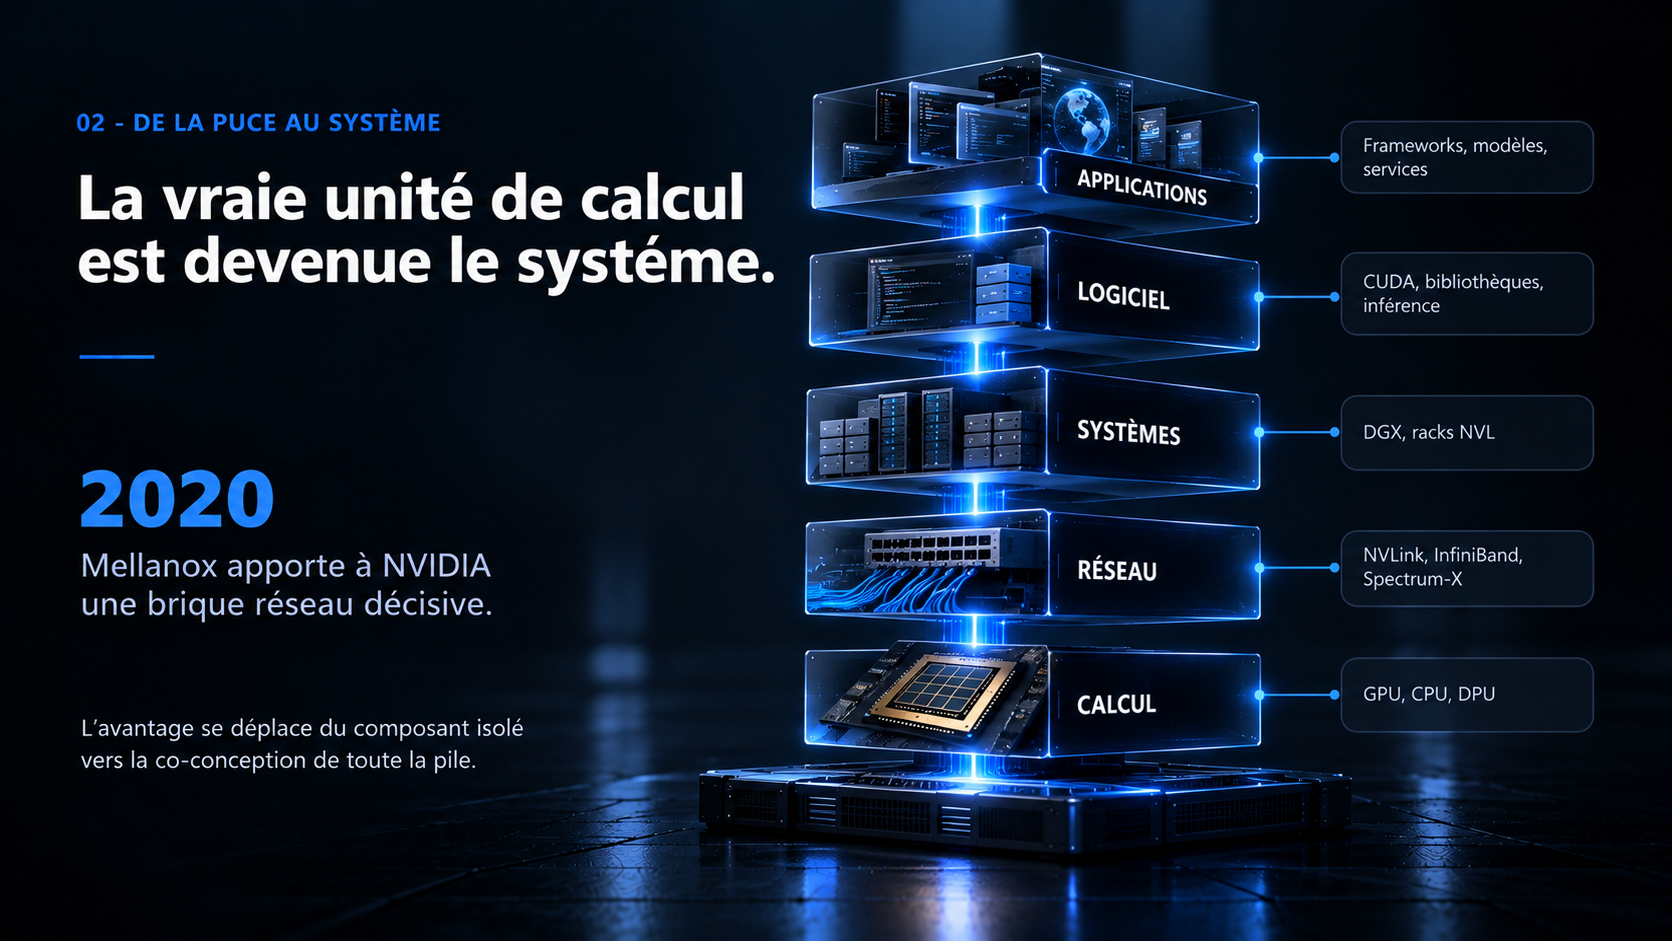
Cette évolution modifie progressivement la définition même du produit.
Le produit NVIDIA peut être une puce.
Mais il peut aussi devenir un module, un serveur, un rack entier ou une architecture de centre de données associant GPU, CPU, DPU, mémoire, commutateurs, interconnexions et logiciels.
4. Le centre de données devient l’unité de calcul
Avec Blackwell puis Vera Rubin, cette logique devient explicite.
NVIDIA conçoit désormais ses plateformes en raisonnant à l’échelle du rack et du centre de données.
La plateforme Vera Rubin NVL72, par exemple, associe 72 GPU Rubin, 36 CPU Vera, des SuperNIC ConnectX-9, des DPU BlueField-4 et NVLink 6, puis utilise InfiniBand ou Spectrum-X Ethernet pour étendre le système au-delà du rack.
NVLink 6 fournit jusqu’à 3,6 To/s de bande passante bidirectionnelle par GPU dans cette génération.
Ce détail technique révèle le changement stratégique.
NVIDIA optimise désormais plusieurs éléments simultanément :
calcul → mémoire → communication → réseau → logiciels → déploiement.
L’entreprise décrit elle-même son Data Center comme une plateforme réunissant calcul et infrastructure réseau, généralement livrés sous forme de systèmes à l’échelle du rack, sous-systèmes ou modules, accompagnés de logiciels et services.
C’est précisément ce qui permet de parler d’infrastructure plutôt que simplement de semi-conducteurs.
5. Pourquoi les clients achètent une plateforme entière
Pour un laboratoire d’IA ou un fournisseur de cloud, l’objectif n’est pas de posséder le GPU théoriquement le plus rapide.
L’objectif est d’obtenir le maximum de calcul utile pour un coût, une consommation énergétique et un temps donnés.
Cela exige que toutes les couches fonctionnent ensemble.
NVIDIA peut alors optimiser ses architectures conjointement : GPU, mémoire, NVLink, réseau, bibliothèques et moteurs d’inférence.
Cette intégration réduit une partie du travail que le client devrait autrement réaliser lui-même pour assembler et optimiser une infrastructure composée de technologies provenant de plusieurs fournisseurs.
Elle crée aussi un mécanisme économique puissant.
Plus l’infrastructure NVIDIA est utilisée, plus les développeurs optimisent leurs applications pour son environnement.
Plus cet environnement logiciel s’enrichit, plus la plateforme devient attractive.
Et plus les volumes augmentent, plus NVIDIA peut investir dans la génération suivante.
Ce cercle ne rend pas la concurrence impossible.
Mais il augmente considérablement le nombre de couches sur lesquelles elle doit être compétitive simultanément.
6. Les chiffres montrent que NVIDIA n’est déjà plus principalement une entreprise de cartes graphiques
L’évolution financière est spectaculaire.
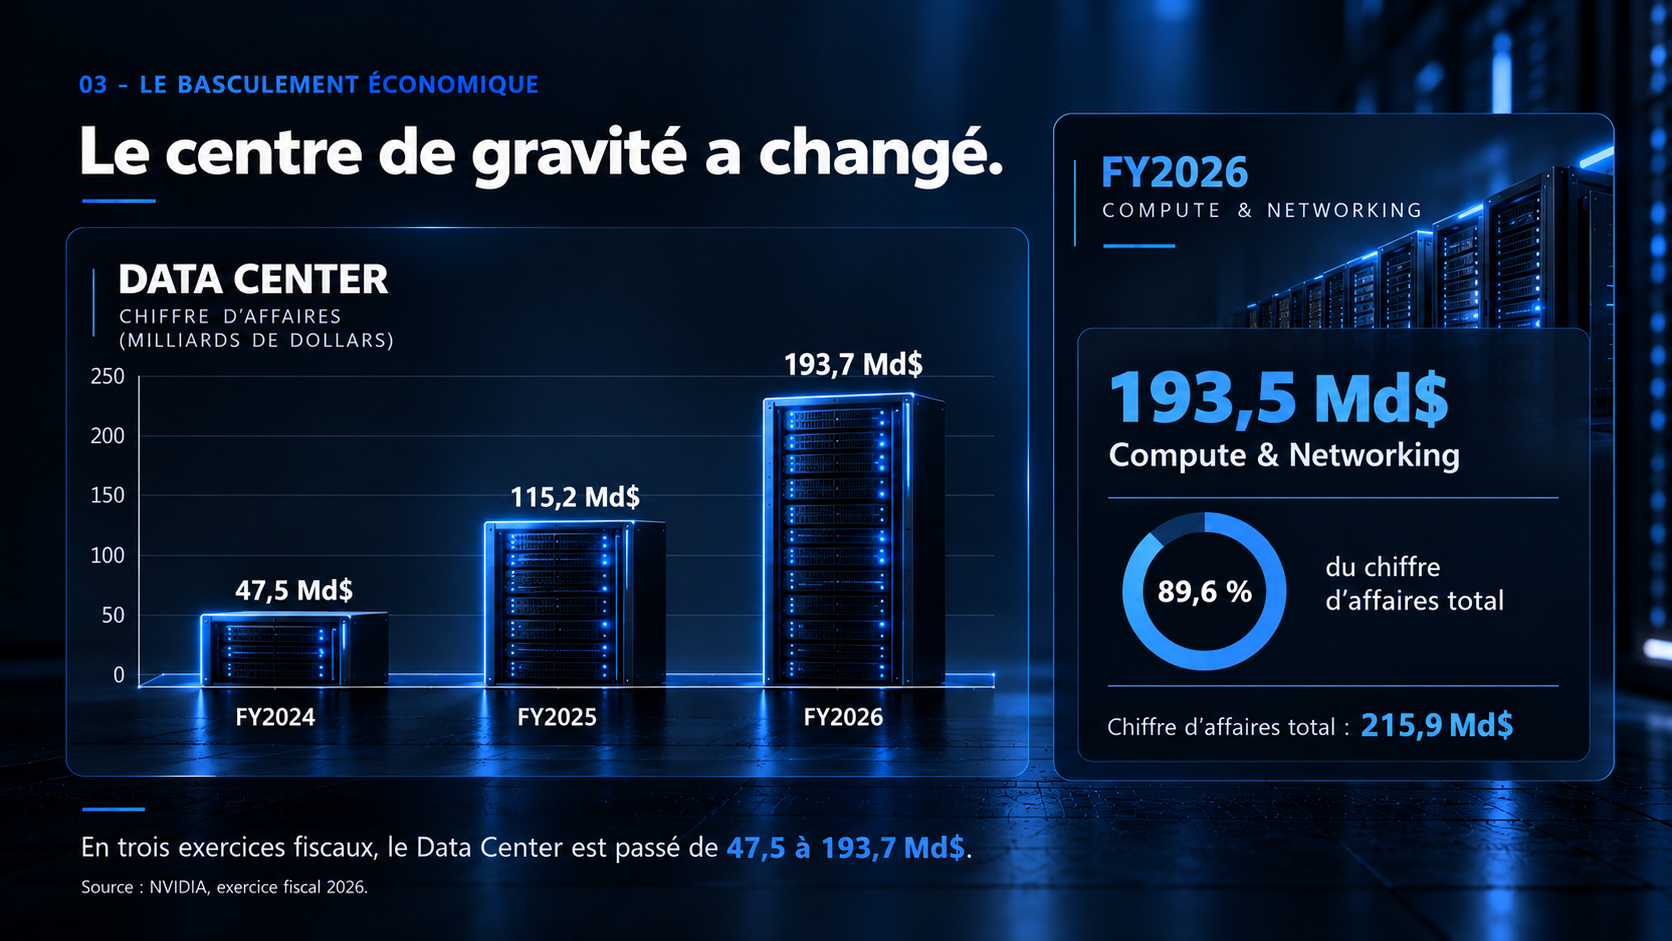
Pour son exercice fiscal 2026, NVIDIA a déclaré 215,9 milliards de dollars de chiffre d’affaires.
Le segment Compute & Networking en représentait 193,5 milliards, soit environ 89,6 % du total. Ce segment avait progressé de 67 % en un an.
Encore plus révélateur : le Data Center représentait 193,7 milliards de dollars sur l’exercice, contre 115,2 milliards un an auparavant et 47,5 milliards deux ans auparavant.
Et la dynamique ne repose plus uniquement sur les accélérateurs.
Sur l’exercice fiscal 2026, les revenus Data Center liés au networking ont augmenté de 142 %, notamment grâce à la montée en puissance de NVLink, Ethernet et InfiniBand.
Autrement dit, la croissance du réseau devient elle-même une preuve du déplacement stratégique de NVIDIA.
L’entreprise ne vend plus uniquement les moteurs du système.
Elle vend de plus en plus les connexions qui permettent à ces moteurs de fonctionner ensemble.
7. NVIDIA essaie maintenant de contrôler le rythme de renouvellement de l’infrastructure
Une infrastructure dominante peut néanmoins être fragilisée si elle évolue trop lentement.
NVIDIA a donc accéléré son calendrier.
Après Hopper et Blackwell, l’entreprise déploie Vera Rubin. Dans son dépôt réglementaire de juillet 2026, NVIDIA indiquait que les premières livraisons de production Vera Rubin avaient commencé au troisième trimestre de son exercice fiscal 2027.
L’objectif stratégique est important : pousser les clients à raisonner non plus seulement en génération de GPU, mais en génération de plateforme complète.
Chaque nouvelle architecture peut modifier simultanément le GPU, le CPU, la mémoire, les interconnexions et le réseau.
La compatibilité logicielle permet ensuite de préserver une partie des investissements réalisés sur les générations précédentes.
C’est une combinaison difficile à reproduire : changer rapidement le matériel sans obliger l’écosystème à repartir de zéro.
8. Mais infrastructure ne veut pas dire invulnérable
La puissance de NVIDIA crée elle-même de nouveaux risques.
Le premier est la concurrence.
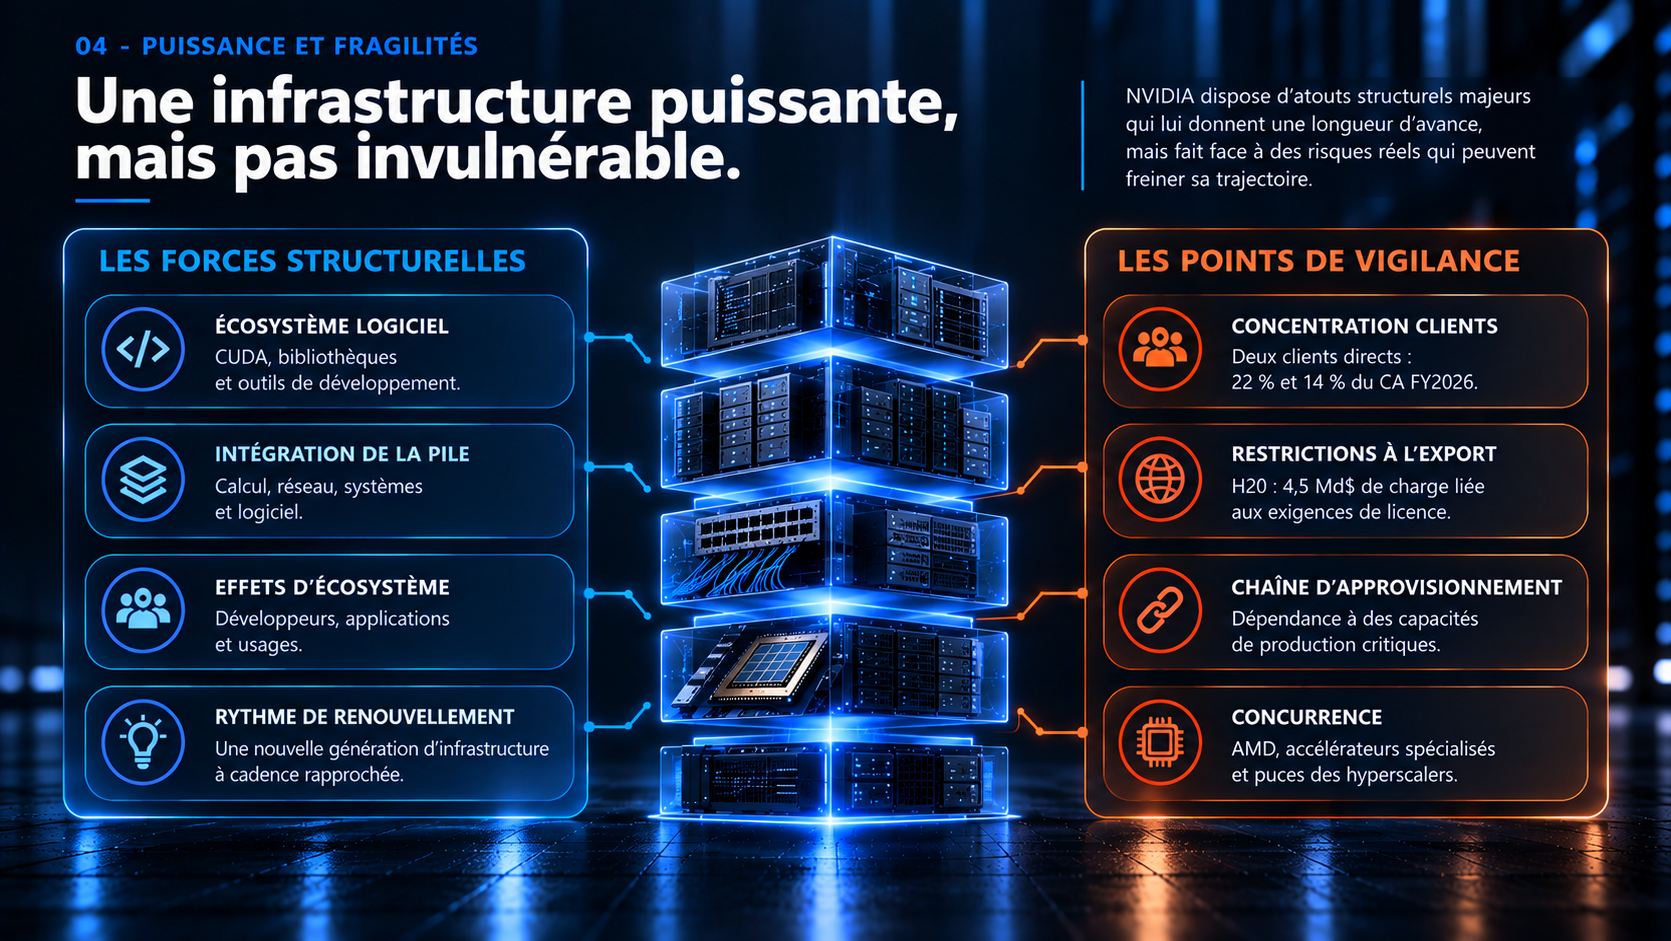
AMD, les accélérateurs spécialisés et les puces développées directement par certains grands fournisseurs de cloud peuvent attaquer certaines couches de la plateforme. NVIDIA reconnaît elle-même une concurrence intense et cite parmi les facteurs compétitifs la performance, le logiciel, les capacités de fabrication, les prix et le coût total des systèmes.
Le deuxième risque est industriel.
NVIDIA conçoit ses puces mais dépend d’une chaîne de fabrication externe. L’entreprise cite notamment TSMC et Samsung pour les wafers, SK Hynix, Micron et Samsung pour la mémoire, ainsi que le packaging CoWoS.
L’ampleur prise par cette dépendance est remarquable : au 26 juillet 2026, NVIDIA déclarait 279 milliards de dollars d’engagements de supply et de capacité destinés principalement à ses systèmes d’infrastructure Data Center.
Le troisième risque est commercial.
Pour l’exercice fiscal 2026, deux clients directs représentaient respectivement 22 % et 14 % du chiffre d’affaires total de NVIDIA.
Le quatrième est géopolitique.
Les restrictions américaines sur certaines exportations vers la Chine ont déjà eu un coût concret. NVIDIA a comptabilisé une charge de 4,5 milliards de dollars liée aux stocks H20 et engagements d’achat après l’introduction de nouvelles exigences de licence en 2025.
Ces contraintes montrent le paradoxe de NVIDIA.
Plus l’entreprise devient une infrastructure essentielle de l’IA, plus elle dépend d’une chaîne industrielle extrêmement complexe, de quelques très grands acheteurs et d’un environnement géopolitique qu’elle ne contrôle pas.
9. Le véritable produit de NVIDIA
Réduire NVIDIA à ses GPU revient donc à regarder seulement la couche la plus visible.
Le GPU reste essentiel.
Mais la valeur stratégique vient de ce qui l’entoure.
CUDA permet de le programmer.
Les bibliothèques permettent d’exploiter ses capacités.
NVLink relie les accélérateurs.
InfiniBand et Spectrum-X étendent le calcul à travers le centre de données.
Les systèmes DGX et NVL assemblent ces composants.
Et les couches logicielles permettent de transformer cette infrastructure en calcul réellement exploitable.
À retenir
- NVIDIA est devenue l’infrastructure de l’intelligence artificielle parce qu’elle a progressivement transformé son avantage dans les GPU en une plateforme intégrée couvrant le calcul, le logiciel, les interconnexions, le réseau et les systèmes complets.
- Son avantage ne vient donc pas d’une seule puce.
- Il vient de la difficulté de remplacer toute la pile en même temps.
- Et c’est aussi là que se trouve son principal défi : pour conserver cette position, NVIDIA doit continuer à faire évoluer l’ensemble de cette infrastructure plus vite que ses concurrents ne parviennent à en désagréger les différentes couches.
Sources
Les données techniques proviennent de la documentation officielle NVIDIA ; les données financières proviennent des dépôts réglementaires de NVIDIA auprès de la SEC.
- NVIDIA — CUDA Programming Guide, Introduction. docs.nvidia.com. Présentation de CUDA, plateforme de calcul parallèle introduite en 2006.
- NVIDIA — Annual CEO Letter 2025. images.nvidia.com. Métriques déclarées par NVIDIA sur l’écosystème de développeurs CUDA.
- NVIDIA — communiqué d’acquisition de Mellanox, 2019. nvidianews.nvidia.com. Annonce de l’acquisition pour une valeur d’entreprise d’environ 6,9 milliards de dollars.
- NVIDIA — technologie Rubin, Data Center. nvidia.com. Spécifications de la plateforme Vera Rubin NVL72.
- NVIDIA Developer Blog — NVLink, the scale-up network for AI factories. developer.nvidia.com. Bande passante de NVLink 6.
- NVIDIA — Rapport annuel 2026. s201.q4cdn.com. Description du segment Data Center comme plateforme intégrée de calcul et de réseau.
- NVIDIA — dépôt SEC, résultats du premier trimestre de l’exercice fiscal 2027 (12 mai 2026). sec.gov. Chiffre d’affaires de l’exercice fiscal 2026, poids du segment Compute & Networking et croissance du networking Data Center.
- NVIDIA — dépôt SEC, annexe financière détaillée. sec.gov. Évolution du chiffre d’affaires du segment Data Center sur trois exercices fiscaux.
- NVIDIA — dépôt SEC, formulaire 10-Q (26 juillet 2026). sec.gov. Démarrage de la production Vera Rubin et engagements de supply et de capacité déclarés à cette date.
- NVIDIA — dépôt SEC, formulaire 10-K, exercice fiscal 2026. sec.gov. Facteurs concurrentiels, dépendances de la chaîne d’approvisionnement et charge liée aux restrictions d’export vers la Chine.
- NVIDIA — dépôt SEC, rapport annuel, exercice fiscal 2026. sec.gov. Concentration du chiffre d’affaires auprès des principaux clients.